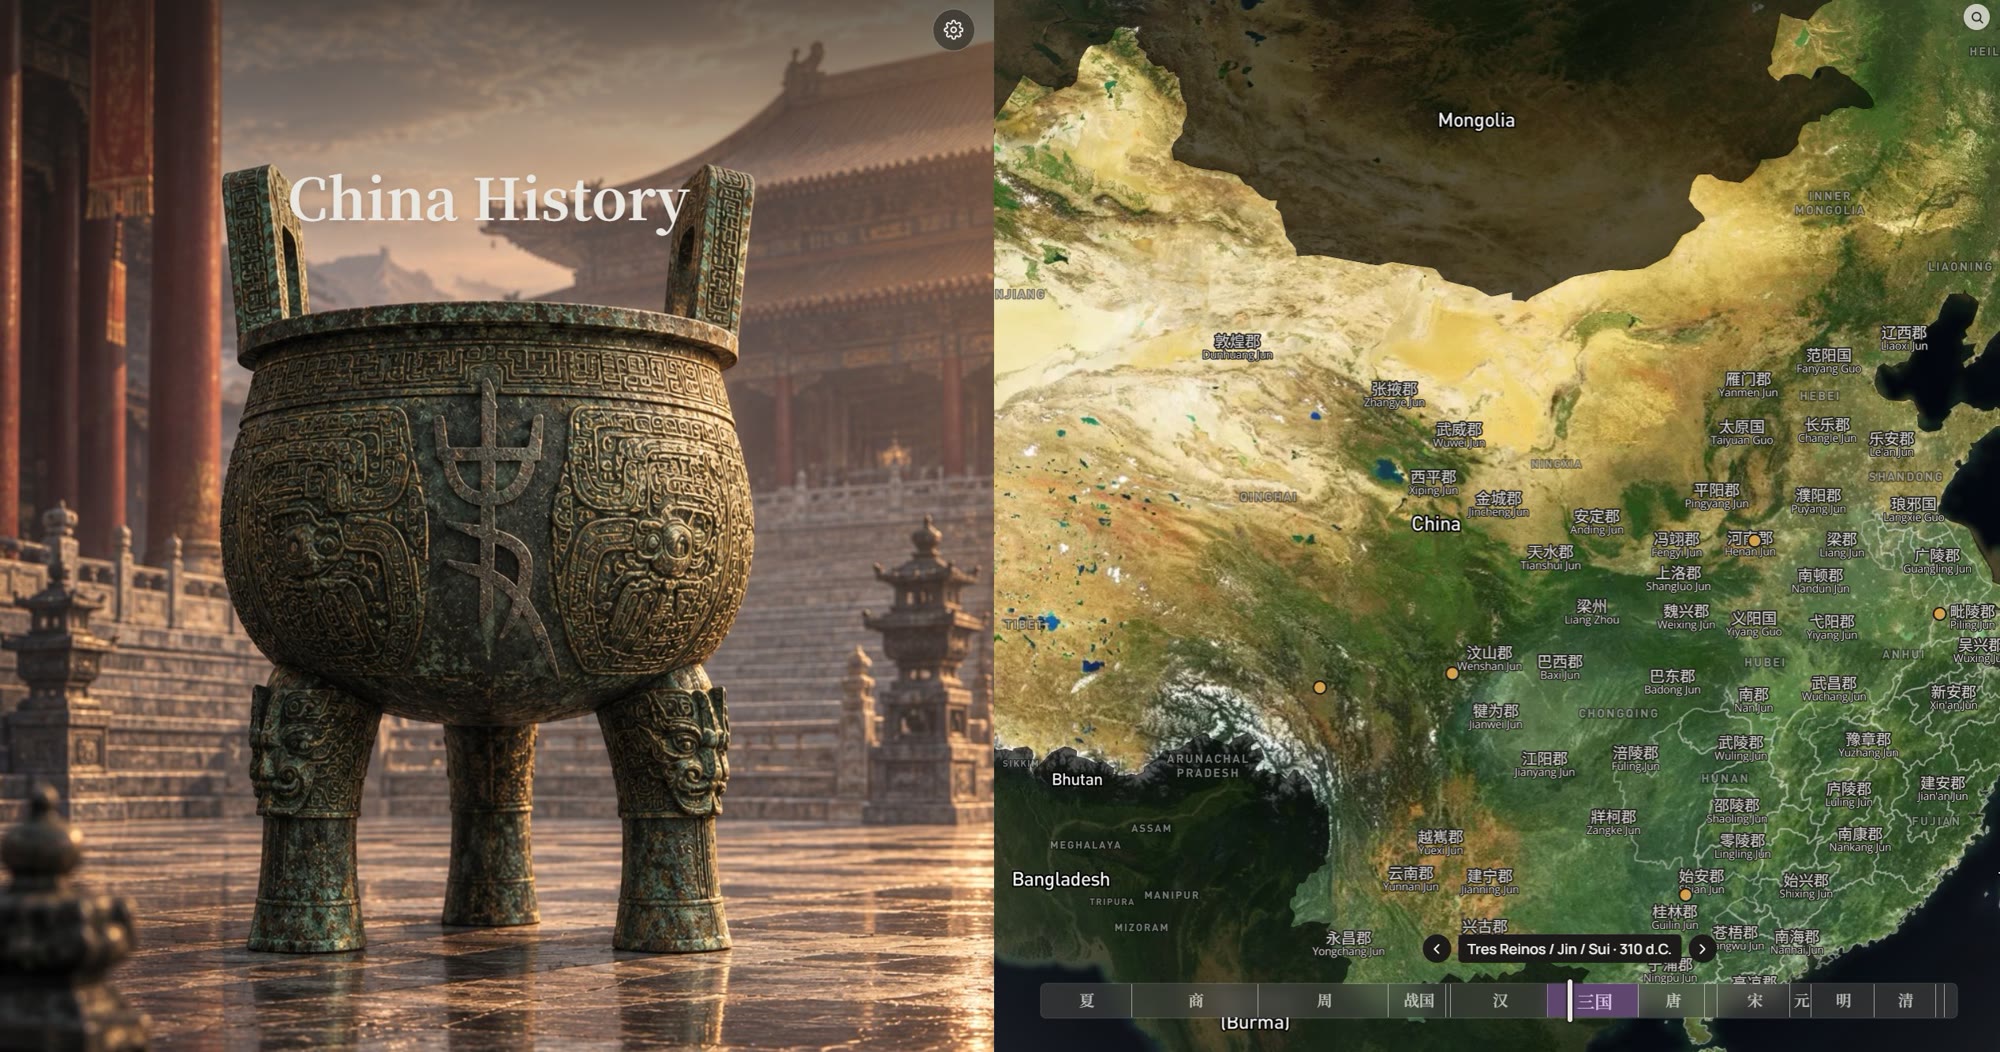
China History
能够自我改进的中国历史生成器
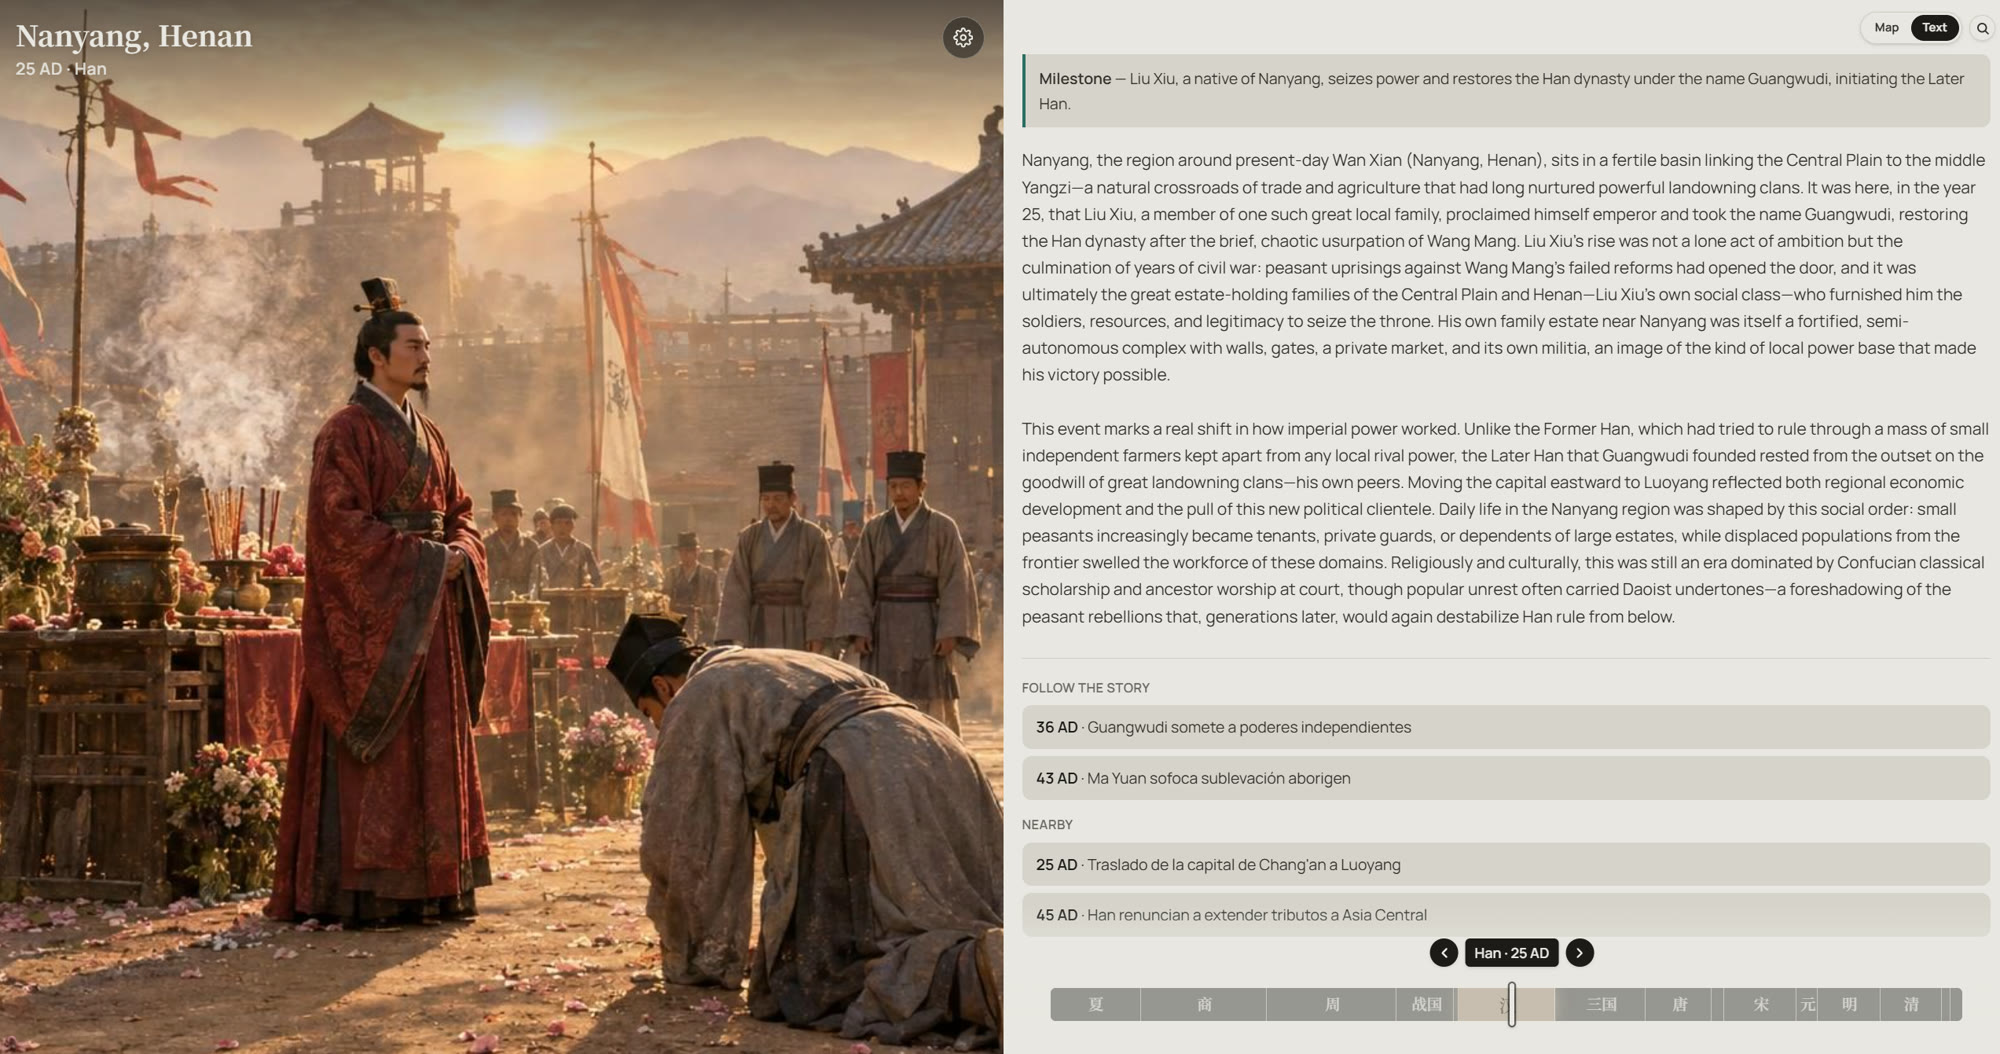
三个大语言模型相互对话,尽可能忠实地在任何地点、任何时间重现中国历史:在地图上随意点击,选择年份,即可实时获得叙述和写实风格的插图,内容以真实史料为依据,而不是模型泛泛的幻觉。
三个大语言模型
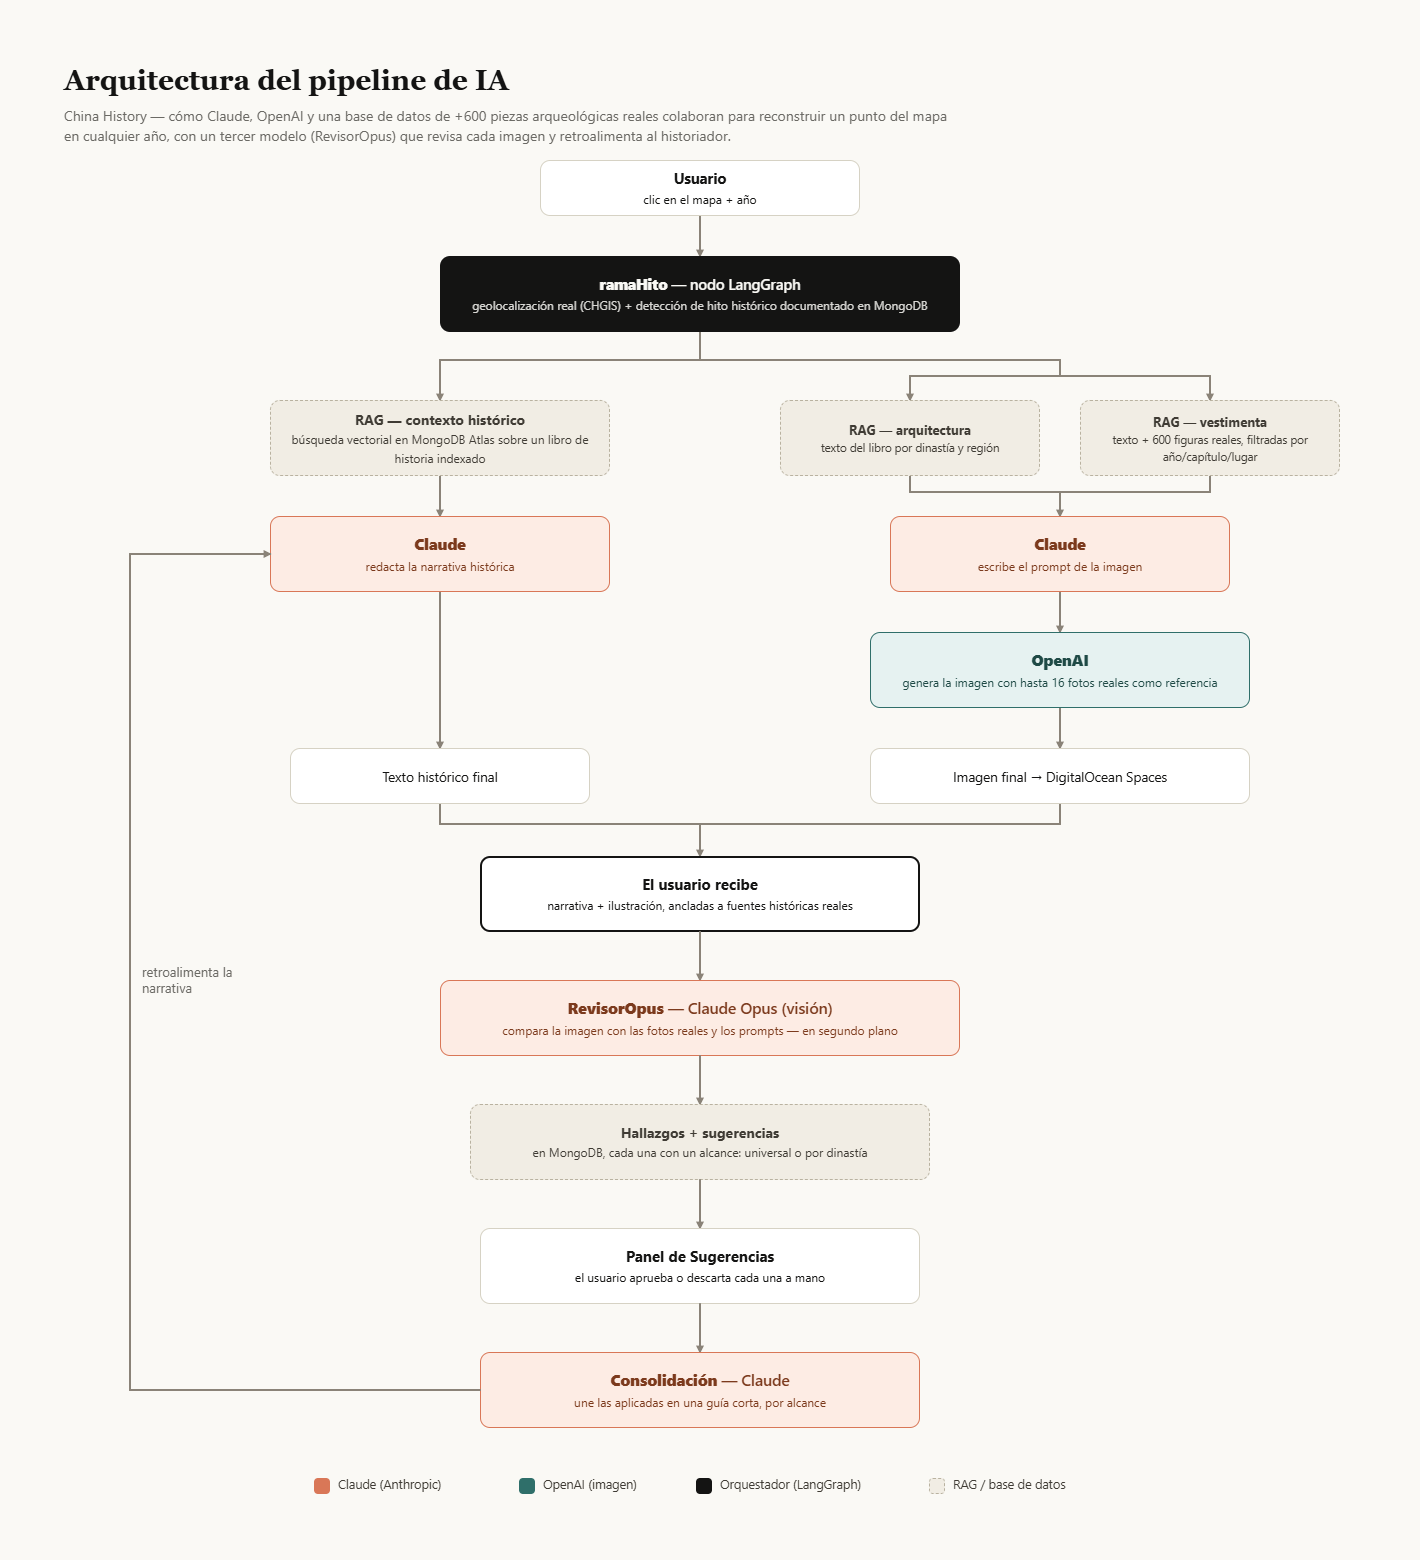
- 历史学家 — 借助 RAG 流程、图像数据库和自身知识,撰写某地某时的历史,并为插画师编写提示词。
- 插画师 — 负责生成图像的大语言模型,把场景画出来。
- 监督者 — 审查结果并纠正前两者的错误,让下一轮迭代更接近历史真实。
技术亮点
- 基于 LangGraph 的智能体流程 — 用状态图(NestJS + LangChain)编排地理解析、地标识别、针对背景/建筑/服饰的 RAG、提示词构建和图像生成,并为每个阶段做缓存。
- 混合式 RAG,而不只是语义检索 — 我把一本关于中国服饰考古的学术著作索引到 MongoDB Atlas Vector Search 中,但纯向量检索总会返回错误的年代。解决办法是结合结构化过滤(年份、章节、坐标),精确度优先于相似度。
- 600 多件真实考古文物 — 提取并自动分类了数百张照片和线图,每一项都标注了年代、章节和出土地点。
- 多参考图的图像生成 — 系统按类别和地理远近最多挑选 16 张真实参考照片,输入图像编辑模型,并附明确的指令来避免常见错误:把毫不相干的物品混在一起、错配奢侈品、给所有人复制同一件衣服。
- 真实的地理定位 — 集成 CHGIS(哈佛–复旦),按所查询年份所属朝代来解析地名和疆界,而不是用今天的地理。
技术栈
- NestJS
- LangGraph
- LangChain
- MongoDB Atlas
- Anthropic
- OpenAI
- Next.js
- DigitalOcean Spaces